
こんにちは! Data Intelligenceチームの福岡です。
今回は、前回に引き続きLangchainとAzure OpenAIでAIエージェントを構築します。
前回記事はこちらkdl-di.hatenablog.com
前回のまとめ
- AIエージェントとは「AIが自律的に目標達成に向けたデータを収集し、アクションを実行するシステム」
- 旅行者の問い合わせと予約を処理するAIエージェントを実装したい。
- サンプルコードのままではAzure OpenAI Serviceを使用できない。また、手順通りではエラーになる箇所やわかりにくい箇所がある。
- 不足を補いつつAzure OpenAI Serviceを使用できるように修正し、さらにどのような仕組みになっているかを深堀するのが本連載の目的。
- 準備編となる前回は、ドキュメントとベクトルを読み込むまで完了した。
- これにより、Cosmos DBに旅客船や旅行プランの情報が読み込めた(アーキテクチャ図のDATAの部分の準備が完了した)。
本記事では、以下のSERVICEレイヤについて、実際にAPIを呼び出すところから続けます!

API の環境を設定する
APIを呼び出す準備をします。 公式ドキュメントのAPI の環境を設定するの手順に従ってください。 しかし、そのまま実行するとエラーになるので一部を修正します。
修正項目・補足事項
環境構築について
前回記事と同様に、筆者はpyenv + poetryで環境構築をしています。 前回記事で筆者と同様に環境を準備した方は、ここでは以下のように3つのライブラリをインストールすればOKです。
poetry add fastapi
poetry add uvicorn
poetry add langchain-mongodb
環境変数について
前回と同じくOpenAI API をAzure OpenAI Serviceに置き換えるため、手順通りでは不十分です。 以下のように準備してください。
- まず、前回記事でloaderディレクトリの.envに記述した内容をすべてコピーし、今回作成したapi ディレクトリの.envに貼り付けます。
- また、今回は埋め込みモデルだけではなくチャット用モデルも使用します。
- そのため、以下の環境変数を追加してください。デプロイ名は実際のものに置き換えてください。
AZURE_OPENAI_DEPLOYMENT_NAME_CHAT = <チャット用モデルのデプロイ名>
Azure OpenAI Serviceに置き換え
api/data/mongodb/init.py
- langchain_openaiからOpenAIEmbeddingsをインポートしていますが、AzureOpenAIEmbeddingsもインポートします。
- また、SecretStrをインポートします。
from langchain_openai import OpenAIEmbeddings, AzureOpenAIEmbeddings
from pydantic import SecretStr
さらに25行目付近のvector_storeを定義する既存コードをコメントアウトし、Azure OpenAI Serviceに置き換え
    # vector_store = AzureCosmosDBVectorSearch.from_connection_string(MONGO_CONNECTION_STRING,
                                                                    # DB_NAME + "." + COLLECTION_NAME,
                                                                    # OpenAIEmbeddings(disallowed_special=()),
                                                                    # index_name=INDEX_NAME )
    embeddings = AzureOpenAIEmbeddings(
        azure_endpoint=environ.get("AZURE_OPENAI_ENDPOINT"),  # Azure のエンドポイント
        azure_deployment=environ.get("AZURE_OPENAI_DEPLOYMENT_NAME_EMBEDDING"),  # デプロイ名
        api_key=SecretStr(environ.get("AZURE_OPENAI_API_KEY")),  # API キー
        api_version="2023-05-15",  # バージョン指定
        )

    vector_store = AzureCosmosDBVectorSearch.from_connection_string(MONGO_CONNECTION_STRING,
                                                                    DB_NAME + "." + COLLECTION_NAME,
                                                                    embeddings,
                                                                    index_name=INDEX_NAME)
api/service/init.py
冒頭でlangchain_openaiからChatOpenAIをインポートしていますが、AzureChatOpenAもインポートします。
from langchain_openai import ChatOpenAI, AzureChatOpenAI
14行目付近、chatの型アノテーションをAzure OpenAIに準拠したものに修正
# chat : ChatOpenAI | None=None
chat : AzureChatOpenAI | None=None
さらに20行目のchatを定義する既存コードをコメントアウトし、Azure OpenAI Serviceに置き換え
# chat = ChatOpenAI(model_name="gpt-3.5-turbo-16k",temperature=0)
    chat = AzureChatOpenAI(
        deployment_name=environ.get("AZURE_OPENAI_DEPLOYMENT_NAME_CHAT"),  # デプロイ名
        openai_api_key=environ.get("AZURE_OPENAI_API_KEY"),          # APIキー
        openai_api_version="2024-08-01-preview",  # APIバージョン
        azure_endpoint=environ.get("AZURE_OPENAI_ENDPOINT"),         # エンドポイント
        temperature=0  # 応答の多様性を固定
    )
使用するモデルがチャット用なのか埋め込みモデルなのかに注意してください。 ユーザとの対話で生きるのがチャット用モデル、旅行データの検索時に使用するのが埋め込みモデルです。
日本語に対応させる
デフォルトで用意された初期メッセージやシステムプロンプトは英語なので、日本語に直します。
api/service/init.py
34行目にシステムプロンプトが記述されているので、これを日本語にします。 今回は原文をそのまま和訳しました。
             #"You are a helpful and friendly travel assistant for a cruise company. Answer travel questions to the best of your ability providing only relevant information. In order to book a cruise you will need to capture the person's name.",
            "あなたはクルーズ会社の親切でフレンドリーな旅行アシスタントです。旅行に関する質問に可能な限り答え、関連する情報のみを提供する。クルーズを予約するには、相手の名前を把握する必要があります。"
web/src/TripPlanning/TravelAgent.js
16行目の初期メッセージ'Hello, how can I assist you today?'を日本語に変換します。
message: 'こんにちは、お手伝いできることはありますか',
api/data/mongodb/travel.py
DBにロードした旅行プラン情報は英語なため、日本語対応に修正すると検索した内容がヒットしにくくなるようです。 公式ドキュメントのヒントにあるように、検索スコアの閾値を少し*1下げます。
docs_filters = [doc for doc, score in docs if score >=.70]
ここまで完了すれば手順通りにAP環境の設定は終了です。
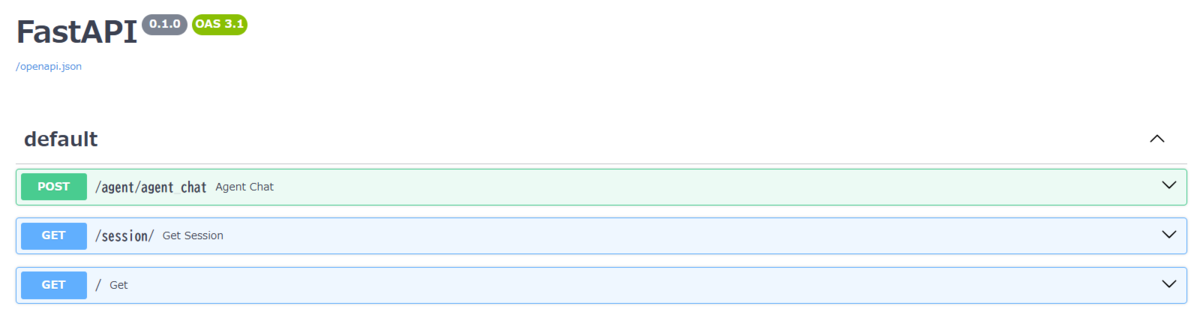
python api/app.pyを実行するとサーバーが立ち上がります。
/docsにアクセスして確認してみてください。
AI エージェント メモリのセッションを使用する
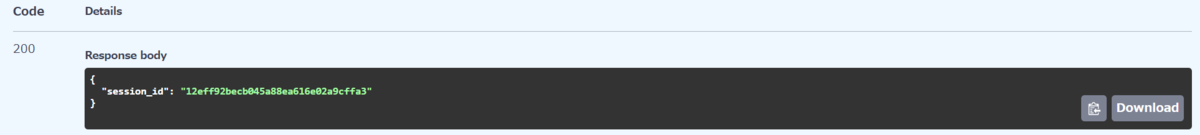
公式ドキュメントにも記述がありますが、AIエージェントと対話的なやり取りをするうえで、対話履歴の参照が不可欠です。 これは、LLMとの対話を固有のセッションIDで管理する形で実装しています。
公式ドキュメントのAI エージェント メモリのセッションを使用するの手順に従ってください。
旅行エージェントとの会話を開始する
公式ドキュメントの旅行エージェントとの会話を開始するの手順に従ってください。
先ほど日本語に対応するように修正したので、希望するプランを日本語で尋ねます。
"session_id"は先ほど生成したセッションIDに置き換えてください

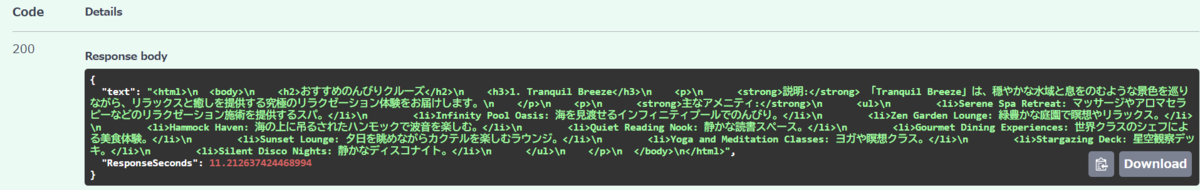
セッションIDごとに過去の会話を記憶してくれます
フロントとの連携
ここまでできたら実際にフロントと連携してみましょう。
公式ドキュメントのReact Web インターフェイスのチュートリアルの手順に従ってください。
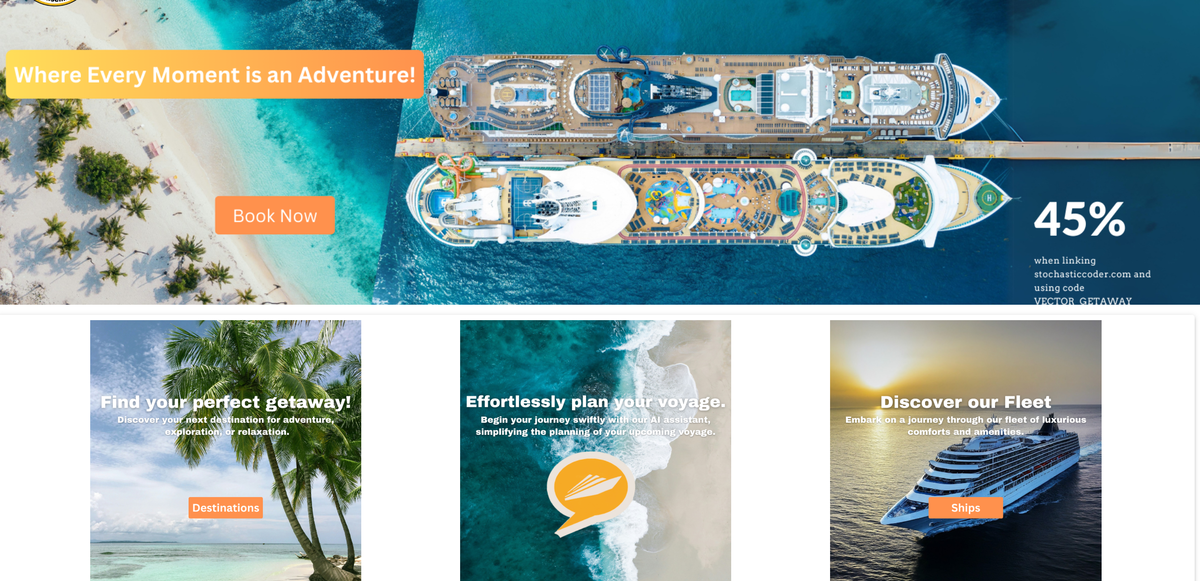
うまくいけば、フロント画面が起動し、準備編の冒頭にあったようなチャットが可能になっています!
AIエージェントの仕組み
さて、おすすめされたプラン(Tranquil Breeze)に行きたいと伝えると代表者氏名と部屋タイプを尋ねたうえで予約を行ってくれます。
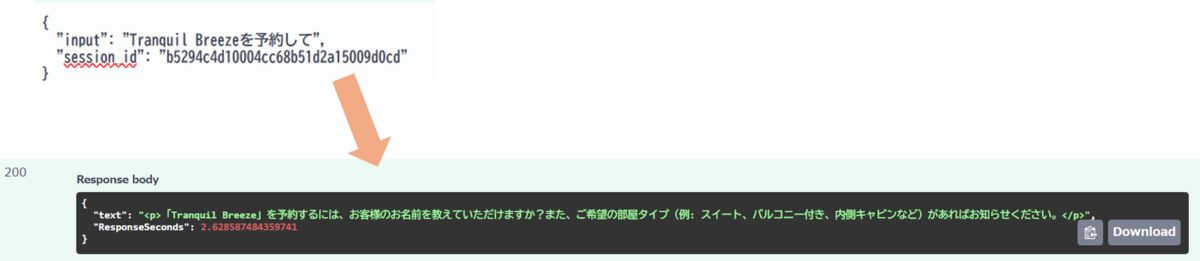
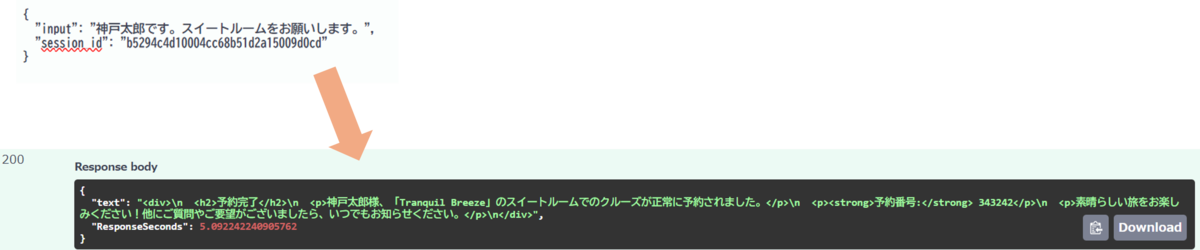
またそもそも、「のんびりした休暇を過ごしたいです」と指示すると該当する旅行プランをDBに検索に行ってくれていました。
これはどのような仕組みなのでしょうか?
キーになるのはエージェントツールです。
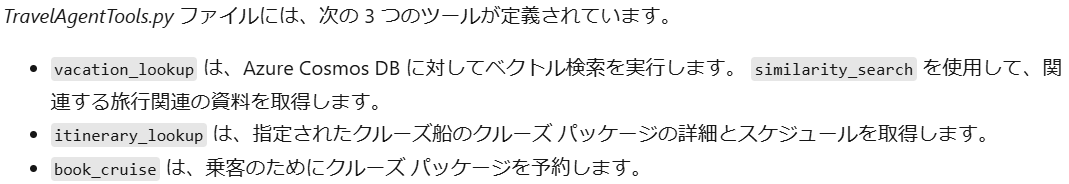
service/init.pyのLLM_init関数に注目してください。 関数内でLLM、ツール、プロンプトを引数にとったエージェントを呼び出しています。
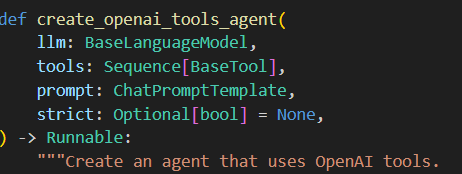
エージェントは用意されたツール群の説明(docstrings)と引数を参照し、その都度必要なものを判断してくれます!
そのため、旅行プランを尋ねるとvacation_lookupツールが実行され、book_cruiseツールが実行される際には不足していた代表者氏名と部屋タイプを尋ねてくれます!!
このように、エージェントがユーザとの対話の中で必要に応じて関数を実行したり、実行に必要な引数を尋ねてくれます。 これがAIエージェント実装のキモになっています。
まとめ
いかがだったでしょうか? 本連載ではLangChainとAzure OpenAIで旅行会社向けのI エージェント実装しました。
2025年はAIエージェントの年・・・なんて噂もささやかれています。 ご興味のある方はぜひ、触ってみて下さい!
*1:ここでは>=.78を>=70にしています

